Comece o monitoramento de site em um passo.
Sem conta e sem agente. Lemos seu site e propomos um monitor.
Analisando o endpoint…
- Sondando o endpoint
- Detectando o tipo de monitor
- Medindo a latência de referência
- Selecionando as melhores regiões
- Preparando as verificações de saúde
Obtendo uma chave temporária…
Instruções para o seu agente
Chave: upz_… (expira em 72 horas)
A área de transferência recusou. Permita o acesso a ela nesta página e copie novamente.
Aguardando a primeira requisição do seu agente…
IA A IA configurou este monitor
Resultado da sonda:
Configurado a partir de medições
A cota gratuita de IA de hoje acabou, então esta proposta é baseada em regras: vem do que a sonda mediu.
A IA não conseguiu responder desta vez, então esta proposta é baseada em regras: vem do que a sonda mediu.
Resultado da sonda:
Seu agente criou este monitor.
Este endereço pediu credenciais. Adicione-as aqui para que a primeira verificação leia a resposta real, ou recomece.
Página de status
Pré-visualização Criando No arLeva o nome do seu site. Os visitantes podem abri-la assim que ela for criada.
Ela já está no ar. Abra em uma nova aba; ela continua funcionando, com ou sem você criar uma conta.
A verificação humana não foi concluída. Tente novamente e recarregue a página se continuar falhando.
Tentativas demais a partir desta rede. Tente novamente mais tarde.
Não conseguimos acessar esse endereço. Confirme que ele é público e está respondendo, depois tente novamente.
Isso não parece um endereço da web. Informe o endereço completo, começando com https://.
Esse endereço aponta para uma rede privada, que não verificamos. Informe um endereço público.
Este navegador já usou sua análise gratuita. Crie uma conta para continuar
Já há uma análise em andamento neste navegador. Aguarde o fim dela e tente novamente.
A análise está demorando mais do que o normal. Tente novamente em instantes.
A análise não foi concluída. Execute-a novamente ou crie uma conta para configurar o monitor manualmente.
Não conseguimos acessar o Uptizm. Verifique sua conexão e tente novamente.
Algo deu errado do nosso lado. Tente novamente em instantes.
Já existe uma conta com este e-mail. Entre nela pelo app; este monitor é associado a ela assim que você entrar.
Escolha uma senha mais forte.
Este endereço exige credenciais. Ative a chave de credenciais e preencha os campos.
Não conseguimos concluir a configuração. Toque no botão novamente; o que você informou foi mantido.
Não foi possível entrar com esse provedor. Tente novamente ou crie a conta com o seu e-mail.
Monitoramento de uptime que se recusa a adivinhar.
Aponte para uma URL, escolha as regiões e a verificação começa. Sem agente, sem sidecar, nada nosso rodando na sua infraestrutura.
Plano gratuito: 3 monitores com verificações de 5 min, uma página de status. Sem cartão.
Cole uma URL: a IA a sonda e propõe o monitor, e você o cria. Sem agente, sem sidecar, nada nosso rodando na sua infraestrutura.
Uma única especificação assinada é distribuída a todas as 5 regiões no mesmo ciclo. Assim, uma região lenta é um fato sobre ela, e não sobre quando chegou a sua vez.
eu-west falhou uma vez. As outras regiões responderam no mesmo ciclo, então a sequência ficou em 0 e nenhum incidente foi aberto.
Todas as regiões fora do ar por 2 ciclos seguidos: o incidente abre sozinho e a escada de escalonamento começa. Reconhecê-lo interrompe a escada.
Sua equipe recebe um push em Web, iOS e Android, conforme as próprias configurações de notificação.
Os incidentes abertos são analisados pela IA a partir das evidências. Ela redige a próxima atualização pública, você revisa e publica, e quando as verificações se recuperam o incidente é resolvido e sua página de status acompanha.
Como ele decide
Todo alerta tem uma regra por trás. Aqui estão elas.
Toda ferramenta de monitoramento promete não acordar você à toa. Estas são as quatro regras que decidem, escritas em vez de prometidas, para você conferi-las com o último falso alarme que o chamou.
E cada verificação registra qual data center a respondeu, de modo que um caso regional seja evidência, e não palpite.
- US East
- US West
- EU West
- EU Central
- Asia-Pacific
-
Um ciclo, todas as regiões
1 job × 5 regions / tickAs 5 regiões rodam no mesmo ciclo, sem esperar a vez; assim, uma região lenta é um fato sobre ela, e não sobre o lugar que ocupava numa fila.
-
Uma região saudável zera a sequência
any non-down result → consecutive_fails = 0Um único sucesso, de qualquer lugar, zera a contagem de falhas. Ou seja, uma região com um minuto ruim não consegue chamar você sozinha.
-
Não a primeira falha, e sim 2 seguidas
incident_threshold = 2Um incidente só abre quando a sequência de falhas passa do limite. O padrão é 2, então uma oscilação passageira é absorvida e uma interrupção contínua ainda abre no ciclo seguinte. Ajustável por monitor.
-
Uma falha nossa não é uma interrupção sua
refusal → last_status untouchedQuando a nossa própria borda recusa uma sonda, isso é registrado como problema de configuração e mostrado a você. Não altera o status, não altera a sequência e não chama ninguém.
O que ele inspeciona
Um 200 só indica que alguma coisa respondeu.
Sua fila pode ter quarenta mil itens, seu certificado pode ter nove dias restantes, e seu endpoint ainda vai retornar 200 todo animado. Por isso, uma verificação aqui lê mais do que o código recebido.
O que voltou
{
  "status": "ok",
  "queue": { "depth": 4812, "workers": 8 },
  "build": "2.31.0"
}
Seletor
$.queue.depth
Limite
warn ≥ 1000
-
Um número tirado do corpo da resposta
Aponte um seletor para um valor que seu endpoint já retorna, defina um limite, e ele vira um sinal de primeira classe: aparece em gráfico, tem limiar e pode abrir um incidente sozinho. São 5 tipos de seletor, e você pode testar um contra uma resposta real antes de salvar.
json_path · regex · xpath · header · http_status -
O certificado, antes que ele cause problema
O certificado TLS de cada monitor acompanhado é lido periodicamente. Dentro da janela de aviso, um incidente abre uma vez, e não a cada execução, e a data de expiração fica no monitor, onde você a vê chegando.
ssl_alert_threshold_days = 14 -
Um orçamento de erros de verificações reais
Defina uma meta por monitor e o orçamento restante é calculado a partir das verificações que de fato rodaram. Quando não há histórico suficiente para responder, ele avisa em vez de mostrar um zero confiante.
slo_target, per monitor
Plantão
Quem é acordado, até alguém responder.
Um incidente se anuncia nos canais da sua equipe assim que é aberto: Slack, Webhook, PagerDuty, Microsoft Teams. Cada pessoa da equipe também recebe por e-mail, conforme as próprias configurações de notificação. Uma notificação push também chega aos dispositivos.
Escalas de plantão com políticas de escalonamento, a partir do plano Starter. Cada etapa aciona quem estiver de plantão ou uma pessoa indicada pelo nome depois do seu próprio atraso.
-
Reconhecer o incidente encerra os acionamentos
Quem assume o incidente o reconhece. Ele passa para Em investigação, então ninguém mais abaixo na escada é acionado.
acknowledge → ladder stops -
Trabalho planejado não acorda ninguém
Uma janela de manutenção silencia os alertas por padrão. Enquanto ela cobre um monitor, ninguém é acionado e o incidente continua registrado. Se o incidente ainda estiver aberto quando a janela fechar, a escala de plantão retoma.
maintenance window open → no page -
Um SMS para uma interrupção real
20 SMS por mês para interrupções confirmadas a partir do plano Starter, mais nos planos superiores. Os SMS vão para pessoas que ativaram o recebimento com um número de telefone, em caso de interrupção em um monitor verificado a partir de mais de uma região.
sms_monthly = 20
- t+0 Canais da equipe enviado
- t+5m Quem estiver de plantão enviado
- Reconhecido, então a escada para aqui.
- t+10m A pessoa seguinte não enviado
Páginas de status
Durante uma interrupção, seu canal mais silencioso é o que mais fala.
Uma página que seus clientes alcançam quando nada mais seu está no ar. Ela responde à pergunta antes que chegue à sua caixa de entrada e continua respondendo depois que você for dormir.
- Componentes e grupos de componentes
- 90 dias de disponibilidade por componente
- Histórico de incidentes com post-mortems publicados
- Assinantes por e-mail, com dupla confirmação
- A cor e o logotipo da sua marca
- Em um caminho ou em um subdomínio próprio
A mesma página é renderizada como imagem a cada alteração, para você ver o que um cliente vê sem precisar publicar.
Painel ao vivo
Um painel só seu, ao vivo conforme as verificações chegam.
Fixe monitores ou métricas em um painel que é só seu: o seu layout não muda nada para o resto da equipe.
- Status do monitor Exibido como um cartão.
- Tempo de resposta Exibido como um cartão, um gráfico ou uma lista.
- Disponibilidade Exibido como um cartão.
- Métrica Exibido como um cartão, um gráfico ou uma lista.
Cada bloco pode ser pequeno, médio ou grande. As verificações chegam por um canal privado em tempo real assim que acontecem, então um bloco se atualiza sem recarregar a página.
check.recorded → tile refreshes
API e agentes
Seu monitoramento, programável por script.
As chaves de API da equipe abrem a mesma API em que o próprio app roda, para seus scripts, seu CI ou um agente de código.
-
Cada chave carrega apenas as permissões que você concede: 19 permissões em 10 recursos. Ou comece por uma predefinição: somente leitura, leitura e escrita, completo.
monitorsmetricsincidentsstatus_pageschannelsoncallmaintenanceboardstatsteam
- O plano Free inclui 2 chaves.
- Claude Code, ChatGPT, Cursor, Codex ou qualquer cliente MCP se conecta ao servidor MCP da Uptizm, com sua conta Uptizm ou com uma chave de API da equipe. A skill de agente da Uptizm ensina como operar seu monitoramento com segurança.
- A documentação também é escrita para um agente ler: uma especificação OpenAPI, llms.txt, Markdown para cada página.
- Toda página de status pública também responde em status.json, além de llms.txt para um agente.
curl https://api.uptizm.com/v1/me \
  -H "Authorization: Bearer $UPTIZM_API_KEY" \
  -H "Accept: application/json"
Servidor MCP, para qualquer cliente MCP
https://mcp.uptizm.comSkill para agentes
npx skills add uptizm/skillsO limite da IA
Ela lê as medições e não inventa nada.
Uma IA que chuta uma causa é pior do que nenhuma IA, porque às três da manhã você age com base nela. Por isso os limites vêm primeiro: ela cita apenas as verificações, regiões e métricas que consegue ver, escreve as evidências a favor e contra e, onde não sabe, diz que não sabe.
Você define o que ela pode fazer
- Desligado
- Limiares e pessoas abrem incidentes. A IA fica de fora, embora a detecção de anomalias ainda avise na sua caixa de entrada sobre leituras incomuns nos planos pagos.
- Sugerir
- A detecção de anomalias é estatística e roda do Starter em diante. A IA rotula cada achado e escreve uma análise nos incidentes. Quem decide é você.
- Automático
- No Pro, ela mesma abre incidentes de anomalia, os mantém atualizados e os resolve quando o sinal se normaliza.
O que ela não consegue ver: seus deploys, seus commits, seu CI; seus logs, seus traces, seu APM; sua CDN ou a página de status de terceiros
O Uptizm observa seus endpoints de fora, e isso é tudo o que ele sabe. Por isso pode dizer que a fila ultrapassou o limite três verificações antes do primeiro 503. Não pode dizer que um deploy causou isso, e não vai fingir o contrário.
As sugestões são conselhos. Não existe botão que a deixe tocar na sua infraestrutura, porque ela não tem como entrar.
E a IA está incluída no plano, sem cobrança por incidente. Uma IA paga por uso manda a maior fatura no seu pior dia, e um recurso que você hesita em deixar rodar não é um recurso.
Baixe o app
A mesma conta em cada tela.
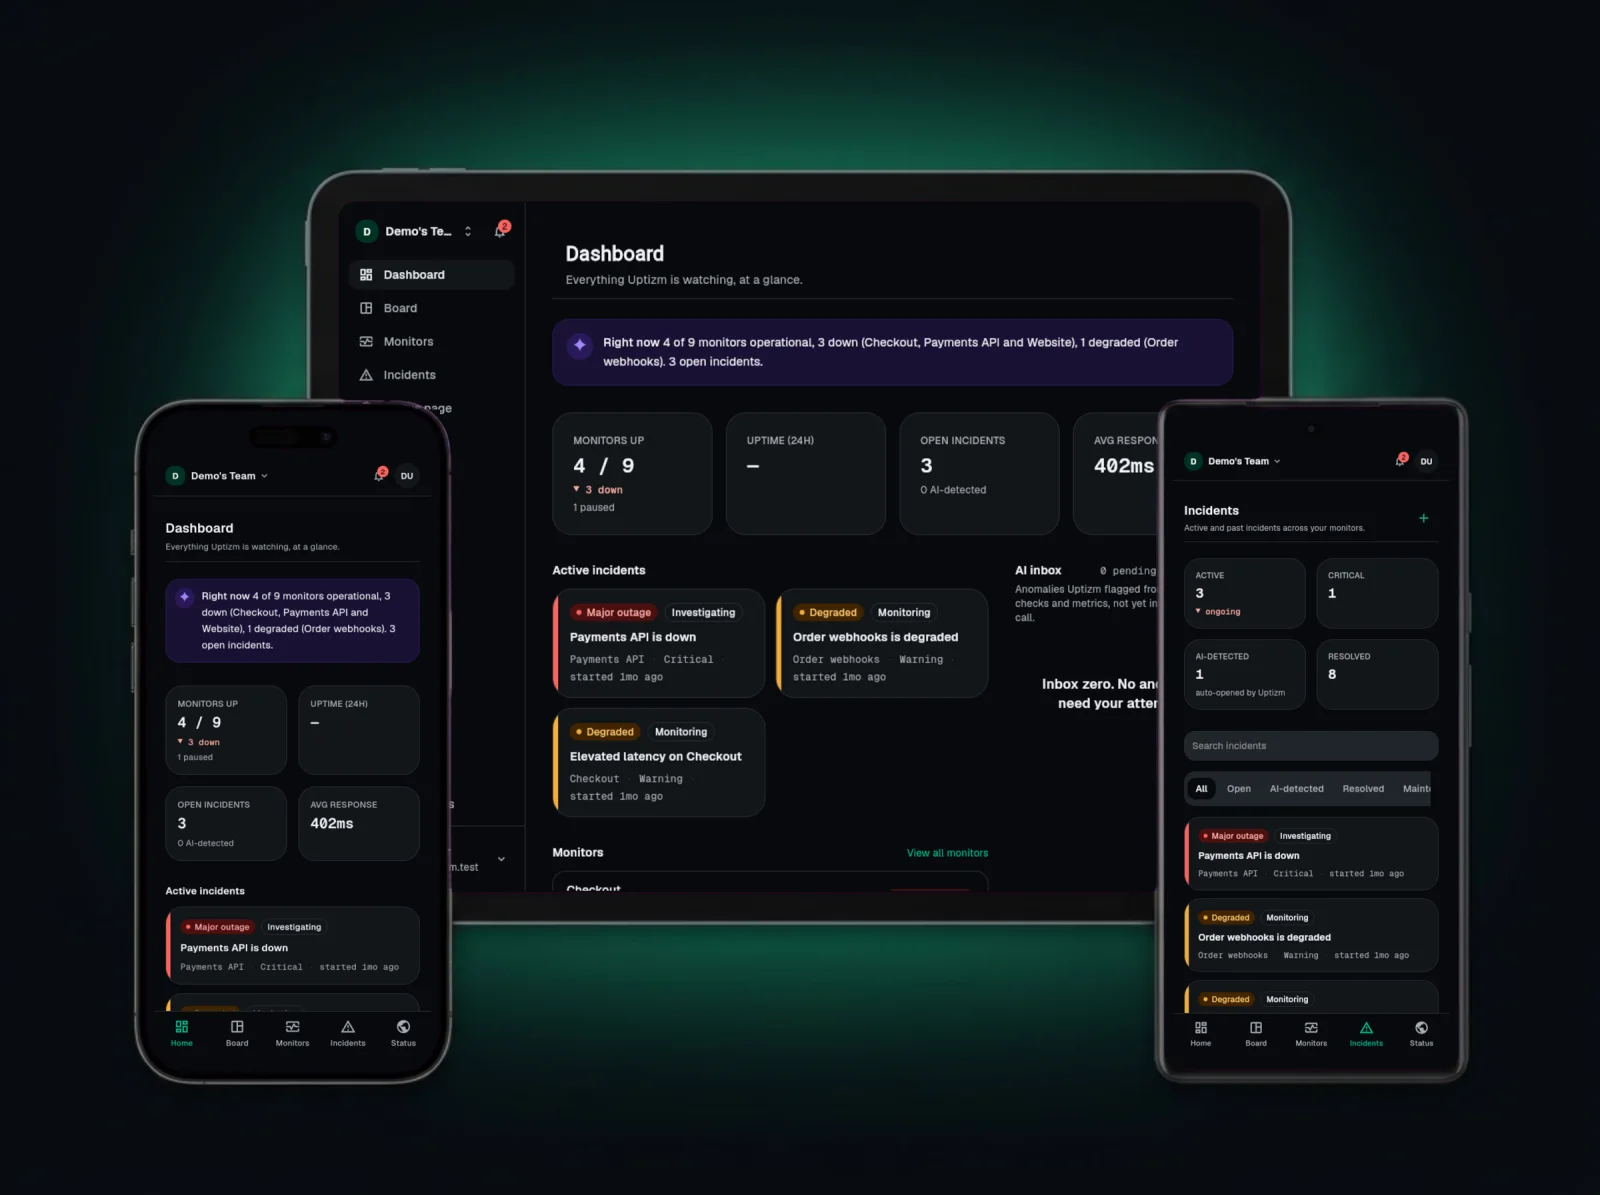
Um único app para Web, iOS, Android, construído a partir do mesmo código-fonte. Entre com a mesma conta em qualquer um deles: a mesma equipe, os mesmos monitores, os mesmos incidentes.
Os incidentes chegam ao seu celular como notificação push, conforme as suas configurações de notificação.