Starten Sie Website Monitoring für Ihre Seite in einem Schritt.
Kein Konto, kein Agent. Wir lesen Ihre Website und schlagen einen Monitor vor.
Endpunkt wird analysiert…
- Endpunkt wird geprüft
- Monitor-Typ wird erkannt
- Basis-Latenz wird gemessen
- Passende Regionen werden gewählt
- Prüfungen werden entworfen
Temporärer Schlüssel wird geholt…
Anleitung für Ihren Agenten
Schlüssel: upz_… (läuft in 72 Stunden ab)
Die Zwischenablage wurde verweigert. Erlauben Sie dieser Seite den Zugriff und kopieren Sie erneut.
Warten auf die erste Anfrage Ihres Agenten…
KI Die KI hat diesen Monitor eingerichtet
Prüfergebnis:
Aus Messwerten eingerichtet
Das kostenlose KI-Kontingent von heute ist aufgebraucht, daher ist dieser Vorschlag regelbasiert: Er stammt aus den Messwerten der Prüfung.
Die KI konnte diesmal nicht antworten, daher ist dieser Vorschlag regelbasiert: Er stammt aus den Messwerten der Prüfung.
Prüfergebnis:
Ihr Agent hat diesen Monitor erstellt.
Diese Adresse verlangt Zugangsdaten. Tragen Sie sie hier ein, damit die erste Prüfung die echte Antwort liest, oder beginnen Sie neu.
Statusseite
Vorschau Wird erstellt LiveBenannt nach Ihrer Website. Besucher können sie öffnen, sobald sie erstellt ist.
Sie ist jetzt live. Öffnen Sie sie in einem neuen Tab; sie läuft weiter, ob Sie ein Konto erstellen oder nicht.
Die Bot-Prüfung wurde nicht abgeschlossen. Versuchen Sie es erneut oder laden Sie die Seite neu.
Zu viele Versuche aus diesem Netzwerk. Versuchen Sie es später erneut.
Wir konnten diese Adresse nicht erreichen. Prüfen Sie, ob sie öffentlich ist und antwortet, und versuchen Sie es erneut.
Das sieht nicht nach einer Webadresse aus. Geben Sie die vollständige Adresse ein, beginnend mit https://.
Diese Adresse zeigt in ein privates Netzwerk, das wir nicht prüfen. Geben Sie eine öffentliche Adresse ein.
Dieser Browser hat seine kostenlose Analyse verbraucht. Erstellen Sie ein Konto, um fortzufahren
Aus diesem Browser läuft bereits eine Analyse. Warten Sie, bis sie fertig ist, und versuchen Sie es erneut.
Die Analyse dauert länger als gewöhnlich. Versuchen Sie es gleich noch einmal.
Die Analyse wurde nicht abgeschlossen. Starten Sie sie erneut oder erstellen Sie ein Konto, um den Monitor manuell einzurichten.
Wir konnten Uptizm nicht erreichen. Prüfen Sie Ihre Verbindung und versuchen Sie es erneut.
Auf unserer Seite ist etwas schiefgelaufen. Versuchen Sie es gleich noch einmal.
Ein Konto nutzt diese E-Mail-Adresse bereits. Melden Sie sich in der App an; der Monitor wird dann Ihrem Konto zugeordnet.
Wählen Sie ein stärkeres Passwort.
Diese Adresse verlangt Zugangsdaten. Aktivieren Sie den Schalter für Zugangsdaten und füllen Sie sie aus.
Wir konnten die Einrichtung nicht abschließen. Drücken Sie die Schaltfläche erneut; Ihre Eingaben bleiben erhalten.
Die Anmeldung über diesen Anbieter hat nicht geklappt. Versuchen Sie es erneut oder legen Sie das Konto mit Ihrer E-Mail-Adresse an.
Verfügbarkeitsüberwachung, die nicht rät.
URL angeben, Regionen wählen, und die Prüfung läuft. Kein Agent, kein Sidecar, nichts von uns läuft in Ihrer Infrastruktur.
Kostenloser Tarif: 3 Monitore im 5-Minuten-Takt, eine Statusseite. Keine Karte.
URL einfügen: Die KI prüft sie und schlägt den Monitor vor, Sie erstellen ihn. Kein Agent, kein Sidecar, nichts von uns läuft in Ihrer Infrastruktur.
Eine signierte Spezifikation geht in einem Durchlauf an alle 5 Regionen. Eine langsame Region sagt dann etwas über diese Region aus, nicht darüber, wann wir sie abgefragt haben.
eu-west ist einmal fehlgeschlagen. Die übrigen Regionen haben im selben Durchlauf geantwortet, daher blieb die Serie bei 0 und es wurde kein Vorfall eröffnet.
Alle Regionen 2 Durchläufe in Folge nicht erreichbar: Der Vorfall eröffnet sich selbst und die Eskalationskette startet. Mit dem Bestätigen endet sie.
Ihr Team erhält eine Push-Mitteilung auf Web, iOS und Android, gemäß den eigenen Benachrichtigungseinstellungen.
Offene Vorfälle analysiert die KI anhand der Belege. Sie entwirft die nächste öffentliche Meldung, Sie prüfen und veröffentlichen sie; erholen sich die Prüfungen, wird der Vorfall behoben und Ihre Statusseite folgt.
Wie es entscheidet
Hinter jedem Alarm steht eine Regel. Hier sind sie.
Jedes Überwachungstool verspricht, Sie nicht grundlos zu wecken. Hier stehen die vier Regeln, die entscheiden, schwarz auf weiß statt versprochen, damit Sie sie mit Ihrem letzten Fehlalarm vergleichen können.
Und jede Prüfung hält fest, welches Rechenzentrum geantwortet hat, damit eine regionale Erklärung ein Beleg ist und keine Vermutung.
- US East
- US West
- EU West
- EU Central
- Asia-Pacific
-
Ein Durchlauf, alle Regionen
1 job × 5 regions / tickAlle 5 Regionen laufen im selben Durchlauf statt nacheinander, daher sagt eine langsame Region etwas über sie selbst aus und nicht über ihren Platz in einer Warteschlange.
-
Eine gesunde Region löscht die Serie
any non-down result → consecutive_fails = 0Ein einziger Erfolg von irgendwoher setzt den Fehlerzähler auf null zurück. Eine Region mit einer schlechten Minute kann Sie also nicht allein alarmieren.
-
Nicht der erste Fehler, sondern 2 in Folge
incident_threshold = 2Ein Vorfall eröffnet sich erst, wenn die Fehlerserie den Schwellenwert erreicht. Standard ist 2: Ein kurzer Aussetzer wird abgefangen, ein anhaltender Ausfall eröffnet im nächsten Durchlauf dennoch. Pro Monitor einstellbar.
-
Unser Fehler ist nicht Ihr Ausfall
refusal → last_status untouchedWenn unser eigener Edge eine Prüfung verweigert, wird das als Konfigurationsproblem erfasst und Ihnen angezeigt. Es ändert weder den Status noch die Serie und alarmiert niemanden.
Was geprüft wird
Ein 200 bedeutet nur, dass etwas geantwortet hat.
Ihre Warteschlange kann vierzigtausend Einträge tief sein, Ihr Zertifikat noch neun Tage gültig, und Ihr Endpunkt liefert trotzdem munter 200. Deshalb liest eine Prüfung hier mehr als den zurückgegebenen Code.
Was zurückkam
{
  "status": "ok",
  "queue": { "depth": 4812, "workers": 8 },
  "build": "2.31.0"
}
Selektor
$.queue.depth
Grenze
warn ≥ 1000
-
Eine Zahl aus dem Antwort-Body
Richten Sie einen Selektor auf einen Wert, den Ihr Endpunkt schon liefert, und geben Sie ihm eine Grenze: Er wird zum vollwertigen Signal, als Diagramm dargestellt, mit Schwellenwert und fähig, selbst einen Vorfall zu eröffnen. 5 Selektor-Arten; vor dem Speichern testen Sie ihn gegen eine Live-Antwort.
json_path · regex · xpath · header · http_status -
Das Zertifikat, bevor es zuschlägt
Das TLS-Zertifikat jedes überwachten Monitors wird regelmäßig gelesen. Im Warnzeitraum eröffnet sich ein Vorfall einmal, nicht bei jedem Durchlauf, und das Ablaufdatum steht am Monitor, sodass Sie es kommen sehen.
ssl_alert_threshold_days = 14 -
Ein Fehlerbudget aus echten Prüfungen
Legen Sie pro Monitor ein Ziel fest; das verbleibende Budget wird aus den tatsächlich gelaufenen Prüfungen berechnet. Reicht die Historie nicht aus, sagt es das, statt eine selbstsichere Null zu zeigen.
slo_target, per monitor
Bereitschaft
Wer geweckt wird, bis jemand antwortet.
Ein Vorfall meldet sich auf Ihren Team-Kanälen, sobald er eröffnet wird: Slack, Webhook, PagerDuty, Microsoft Teams. Jedes Teammitglied erfährt es zusätzlich per E-Mail, gemäß den eigenen Benachrichtigungseinstellungen. Eine Push-Mitteilung erreicht außerdem die Geräte.
Bereitschaftspläne mit Eskalationsrichtlinien, ab Starter. Jede Stufe alarmiert nach ihrer eigenen Verzögerung die Person in Bereitschaft oder eine namentlich genannte Person.
-
Die Bestätigung beendet die Alarmierung
Wer den Vorfall übernimmt, bestätigt ihn. Er wechselt zu „In Untersuchung“, daher wird niemand weiter unten in der Eskalationskette alarmiert.
acknowledge → ladder stops -
Geplante Arbeiten wecken niemanden
Ein Wartungsfenster schaltet Alarme standardmäßig stumm. Solange eines einen Monitor abdeckt, wird niemand alarmiert, und der Vorfall wird trotzdem erfasst. Ist der Vorfall nach dem Ende des Fensters noch offen, setzt die Eskalationskette wieder ein.
maintenance window open → no page -
Eine SMS bei einem echten Ausfall
20 SMS pro Monat bei bestätigten Ausfällen ab Starter, mehr in höheren Tarifen. SMS gehen an Personen, die sich mit einer Telefonnummer dafür angemeldet haben, bei einem Ausfall eines Monitors, der aus mehr als einer Region geprüft wird.
sms_monthly = 20
- t+0 Team-Kanäle gesendet
- t+5m Die Person in Bereitschaft gesendet
- Bestätigt, die Eskalationskette endet hier.
- t+10m Die nächste Person nicht gesendet
Statusseiten
Bei einem Ausfall redet Ihr leisester Kanal am meisten.
Eine Seite, die Ihre Kunden erreichen, wenn sonst nichts von Ihnen läuft. Sie beantwortet die Frage, bevor sie Ihren Posteingang erreicht, und antwortet weiter, wenn Sie längst schlafen.
- Komponenten und Komponentengruppen
- 90 Tage Verfügbarkeit pro Komponente
- Vorfallverlauf mit veröffentlichten Postmortems
- E-Mail-Abonnenten, Double-Opt-in
- Ihre Markenfarbe und Ihr Logo
- Unter einem Pfad oder einer eigenen Subdomain
Dieselbe Seite wird bei jeder Änderung als Bild gerendert, sodass Sie sehen, was ein Kunde sieht, ohne dafür zu veröffentlichen.
Live-Board
Ein eigenes Board, live, sobald Prüfungen eintreffen.
Pinnen Sie Monitore oder Metriken an ein Board, das nur Ihnen gehört: Ihr Layout ändert nichts für den Rest des Teams.
- Monitor-Status Angezeigt als Karte.
- Antwortzeit Angezeigt als Karte, Diagramm oder Liste.
- Verfügbarkeit Angezeigt als Karte.
- Metrik Angezeigt als Karte, Diagramm oder Liste.
Jede Kachel ist klein, mittel oder groß. Prüfungen laufen über einen privaten Echtzeitkanal ein, sobald sie vorliegen, daher aktualisiert sich eine Kachel ohne Neuladen.
check.recorded → tile refreshes
API & Agenten
Ihr Monitoring, per Skript steuerbar.
Team-API-Schlüssel öffnen dieselbe API, auf der die App selbst läuft, für Ihre Skripte, Ihre CI oder einen Coding-Agenten.
-
Jeder Schlüssel trägt nur die Berechtigungen, die Sie ihm erteilen: 19 Berechtigungen für 10 Ressourcen. Oder starten Sie mit einer Vorlage: nur Lesen, Lesen und Schreiben, Vollzugriff.
monitorsmetricsincidentsstatus_pageschannelsoncallmaintenanceboardstatsteam
- Free enthält 2 Schlüssel.
- Claude Code, ChatGPT, Cursor, Codex oder jeder andere MCP-Client verbindet sich mit dem Uptizm-MCP-Server, angemeldet mit Ihrem Uptizm-Konto oder mit einem Team-API-Schlüssel. Der Uptizm-Agent-Skill zeigt ihm, wie er Ihr Monitoring sicher bedient.
- Die Dokumentation ist auch für das Lesen durch einen Agenten geschrieben: eine OpenAPI-Spezifikation, llms.txt, Markdown für jede Seite.
- Jede öffentliche Statusseite antwortet außerdem unter status.json, dazu llms.txt für einen Agenten.
curl https://api.uptizm.com/v1/me \
  -H "Authorization: Bearer $UPTIZM_API_KEY" \
  -H "Accept: application/json"
MCP-Server, für jeden MCP-Client
https://mcp.uptizm.comAgent-Skill
npx skills add uptizm/skillsDie Grenze der KI
Sie liest die Messwerte und erfindet nichts.
Eine KI, die eine Ursache errät, ist schlechter als gar keine, denn um drei Uhr nachts handeln Sie danach. Deshalb sind die Grenzen zuerst gezogen: Sie nennt nur Prüfungen, Regionen und Metriken, die sie sieht, schreibt Belege dafür und dagegen und sagt, wo sie etwas nicht weiß.
Sie legen fest, was sie darf
- Aus
- Schwellenwerte und Menschen eröffnen Vorfälle. Die KI hält sich heraus; die Anomalieerkennung meldet auffällige Messwerte in bezahlten Tarifen aber weiterhin per E-Mail.
- Vorschlagen
- Die Anomalieerkennung ist statistisch und läuft ab Starter. Die KI beschriftet jeden Befund und schreibt Analysen zu Vorfällen. Sie entscheiden.
- Automatisch
- Im Pro-Tarif eröffnet sie Anomalie-Vorfälle selbst, hält sie aktuell und behebt sie, sobald sich das Signal normalisiert.
Was sie nicht sehen kann: Ihre Deployments, Commits, Ihre CI; Ihre Logs, Traces, Ihr APM; Ihr CDN oder die Statusseite eines anderen
Uptizm beobachtet Ihre Endpunkte von außen, und das ist alles, was es weiß. Es kann Ihnen sagen, dass die Warteschlange ihre Grenze drei Prüfungen vor dem ersten 503 überschritt. Es kann nicht sagen, dass ein Deployment die Ursache war, und tut auch nicht so.
Ihre Vorschläge sind Empfehlungen. Es gibt keine Schaltfläche, mit der sie Ihre Infrastruktur anfassen könnte, denn sie hat keinen Zugang.
Und die KI ist im Tarif enthalten, nicht pro Vorfall berechnet. Nutzungsabhängige KI schickt die höchste Rechnung am schlimmsten Tag, und eine Funktion, die Sie nur zögernd laufen lassen, ist keine.
App holen
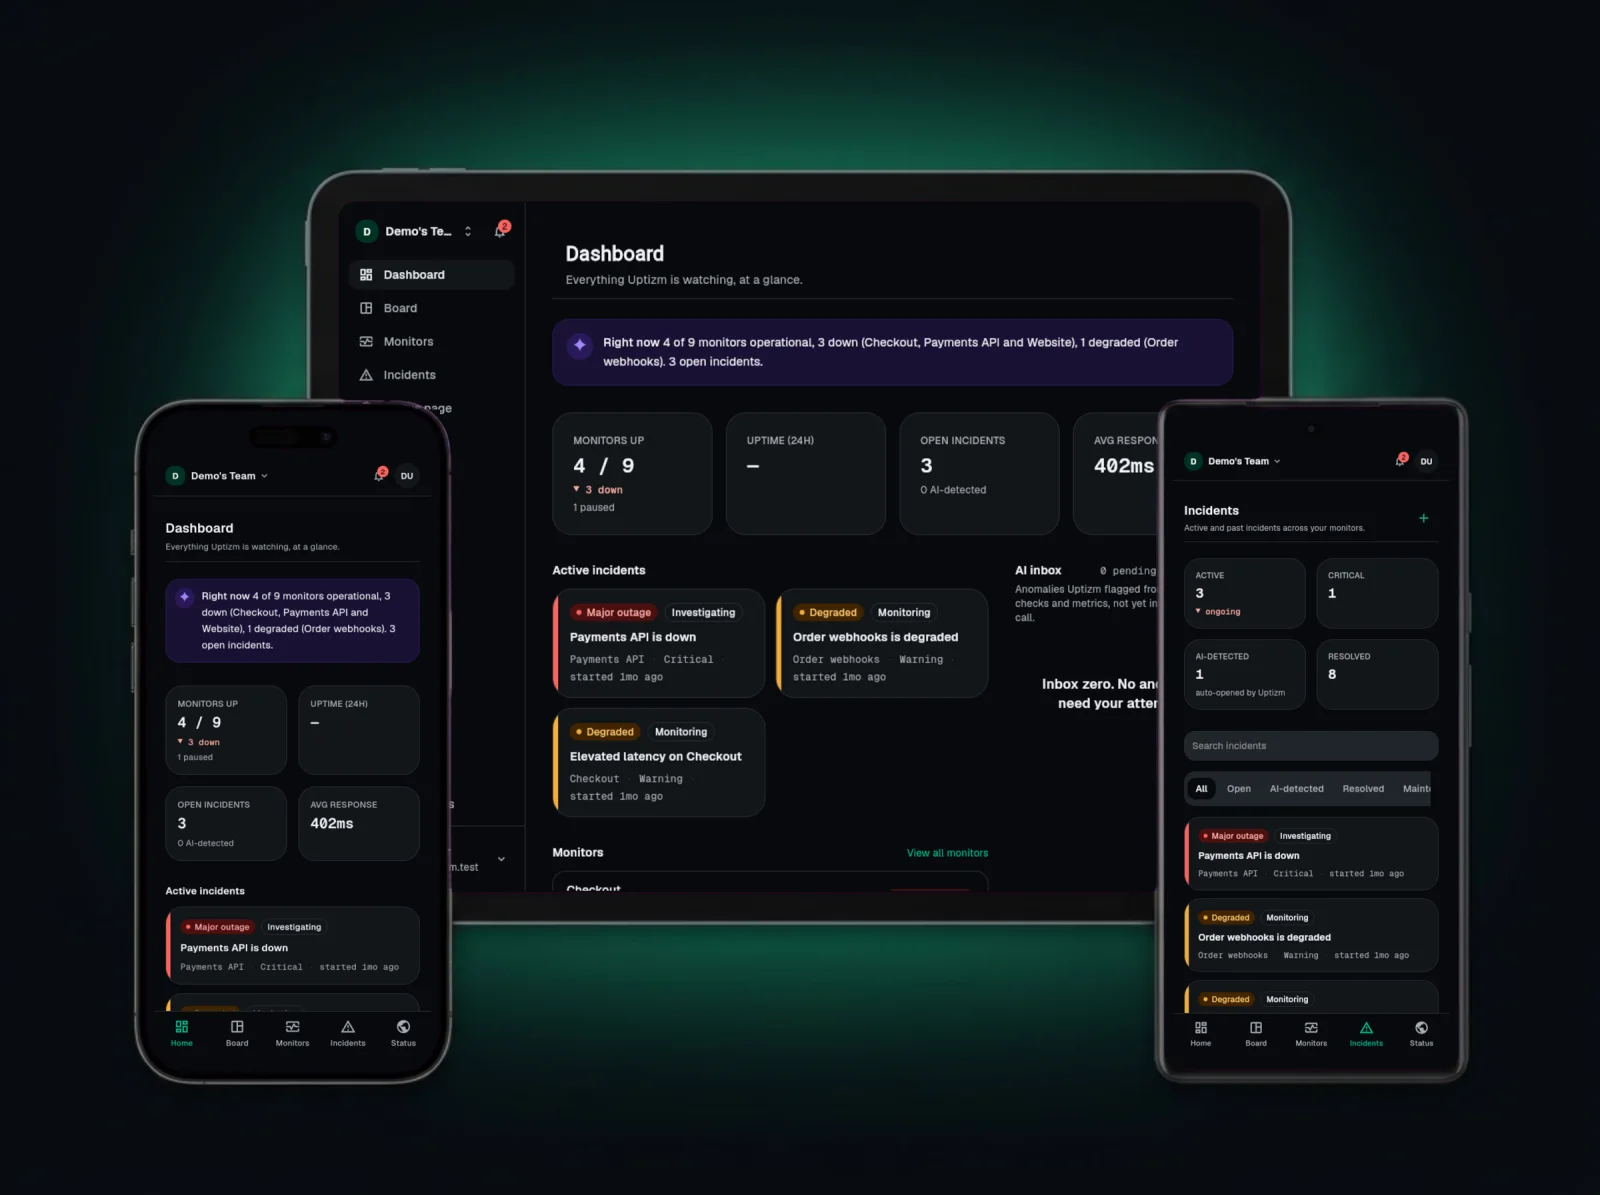
Dasselbe Konto auf jedem Bildschirm.
Eine App für Web, iOS, Android, aus demselben Quellcode gebaut. Melden Sie sich überall mit demselben Konto an: dasselbe Team, dieselben Monitore, dieselben Vorfälle.
Vorfälle erreichen Ihr Telefon als Push-Mitteilung, gemäß Ihren eigenen Benachrichtigungseinstellungen.