Lancez la surveillance de site en une seule étape.
Pas de compte, pas d'agent. Nous lisons votre site et vous proposons un moniteur.
Analyse du point de terminaison…
- Sondage du point de terminaison
- Détection du type de moniteur
- Mesure de la latence de référence
- Choix des meilleures régions
- Rédaction des vérifications
Obtention d'une clé temporaire…
Instructions pour votre agent
Clé : upz_… (expire dans 72 heures)
Le presse-papiers a refusé l'accès. Autorisez-le pour cette page, puis copiez à nouveau.
En attente de la première requête de votre agent…
IA L'IA a configuré ce moniteur
Résultat du sondage:
Configuré d'après les mesures
Le quota d'IA gratuit du jour est épuisé : cette proposition repose sur des règles et provient de ce que la sonde a mesuré.
L'IA n'a pas pu répondre cette fois. Cette proposition repose sur des règles et provient de ce que la sonde a mesuré.
Résultat du sondage:
Votre agent a créé ce moniteur.
Cette adresse a demandé des identifiants. Ajoutez-les ici pour que la première vérification lise la vraie réponse, ou recommencez.
Page de statut
Aperçu Création en cours En ligneElle porte le nom de votre site. Les visiteurs peuvent l'ouvrir dès sa création.
Elle est en ligne. Ouvrez-la dans un nouvel onglet ; elle continue de fonctionner, que vous créiez un compte ou non.
La vérification humaine n'a pas abouti. Réessayez, et rechargez la page si l'échec persiste.
Trop de tentatives depuis ce réseau. Réessayez plus tard.
Nous n'avons pas pu joindre cette adresse. Vérifiez qu'elle est publique et qu'elle répond, puis réessayez.
Ceci ne ressemble pas à une adresse web. Saisissez l'adresse complète, en commençant par https://.
Cette adresse pointe vers un réseau privé, que nous ne vérifions pas. Saisissez une adresse publique.
Ce navigateur a utilisé son analyse gratuite. Créez un compte pour continuer
Une analyse est déjà en cours depuis ce navigateur. Attendez qu'elle se termine, puis réessayez.
L'analyse prend plus de temps que d'habitude. Réessayez dans un instant.
L'analyse n'a pas abouti. Relancez-la, ou créez un compte pour configurer le moniteur à la main.
Nous n'avons pas pu joindre Uptizm. Vérifiez votre connexion et réessayez.
Un problème est survenu de notre côté. Réessayez dans un instant.
Un compte utilise déjà cet e-mail. Connectez-vous-y depuis l'application ; ce moniteur sera rattaché à votre compte dès que vous serez connecté.
Choisissez un mot de passe plus robuste.
Cette adresse demande des identifiants. Activez l'interrupteur des identifiants et renseignez-les.
Nous n'avons pas pu terminer la configuration. Appuyez à nouveau sur le bouton ; ce que vous avez saisi est conservé.
La connexion avec ce fournisseur n'a pas abouti. Réessayez, ou créez le compte avec votre e-mail.
Une surveillance qui refuse de deviner.
Indiquez une URL, choisissez les régions, et les vérifications démarrent. Pas d'agent, pas de sidecar, rien de nous ne tourne dans votre infrastructure.
Forfait gratuit : 3 moniteurs avec vérifications toutes les 5 min, une page de statut. Sans carte.
Collez une URL : l'IA la sonde et propose le moniteur, puis vous le créez. Pas d'agent, pas de sidecar, rien de nous ne tourne dans votre infrastructure.
Une seule spécification signée est diffusée aux 5 régions au même cycle. Une région lente est alors un fait propre à cette région, pas une question de moment où nous nous en sommes occupés.
eu-west a échoué une fois. Les autres régions ont répondu au même cycle : la série est restée à 0 et aucun incident ne s'est ouvert.
Toutes les régions sont indisponibles depuis 2 cycles de suite : l'incident s'ouvre tout seul et l'échelle d'escalade démarre. Le prendre en compte arrête l'échelle.
Votre équipe reçoit une notification push sur Web, iOS et Android, selon ses propres réglages de notification.
Les incidents ouverts sont analysés par l'IA à partir des preuves. Elle rédige la prochaine mise à jour publique, vous la relisez et la publiez ; quand les vérifications se rétablissent, l'incident est résolu et votre page de statut suit.
Comment il décide
Chaque alerte repose sur une règle. Les voici.
Tous les outils de surveillance promettent de ne pas vous réveiller pour rien. Voici les quatre règles qui tranchent, écrites noir sur blanc plutôt que promises : vous pouvez les confronter à la dernière fausse alerte qui vous a appelé.
Et chaque vérification enregistre quel centre de données y a répondu : un scénario régional devient ainsi une preuve, pas une supposition.
- US East
- US West
- EU West
- EU Central
- Asia-Pacific
-
Un cycle, toutes les régions
1 job × 5 regions / tickLes 5 régions s'exécutent au même cycle, sans attendre leur tour : une région lente est donc un fait propre à cette région, pas une affaire de place dans une file.
-
Une seule région saine efface la série
any non-down result → consecutive_fails = 0Un seul succès, d'où qu'il vienne, remet le compteur d'échecs à zéro. Une région qui connaît une mauvaise minute ne peut donc pas vous alerter à elle seule.
-
Pas le premier échec, mais 2 d'affilée
incident_threshold = 2Un incident ne s'ouvre qu'une fois la série d'échecs au-delà du seuil. Par défaut, il est de 2 : un raté passager est absorbé, et une panne durable ouvre quand même un incident au cycle suivant. Réglable par moniteur.
-
Notre défaillance n'est pas votre panne
refusal → last_status untouchedLorsque notre propre périphérie refuse une sonde, c'est enregistré comme un problème de configuration et affiché. Cela ne modifie ni le statut ni la série, et n'alerte personne.
Ce qu'il inspecte
Un code 200 signifie seulement que quelque chose a répondu.
Votre file peut contenir quarante mille tâches, votre certificat n'avoir plus que neuf jours, et votre point de terminaison renverra quand même un joyeux 200. Une vérification ici lit donc davantage que le code reçu.
Ce qui est revenu
{
  "status": "ok",
  "queue": { "depth": 4812, "workers": 8 },
  "build": "2.31.0"
}
Sélecteur
$.queue.depth
Limite
warn ≥ 1000
-
Un nombre tiré du corps de la réponse
Pointez un sélecteur vers une valeur que votre point de terminaison renvoie déjà, donnez-lui une limite, et il devient un signal à part entière : tracé, surveillé par seuil, capable d'ouvrir un incident seul. 5 types de sélecteurs, et vous pouvez en tester un sur une réponse réelle avant de l'enregistrer.
json_path · regex · xpath · header · http_status -
Le certificat, avant qu'il ne coûte cher
Le certificat TLS de chaque moniteur suivi est lu à intervalles réguliers. Dans la fenêtre d'avertissement, un incident s'ouvre une fois, pas à chaque exécution, et la date d'expiration figure sur le moniteur, où vous la voyez venir.
ssl_alert_threshold_days = 14 -
Un budget d'erreurs, issu de vraies vérifications
Fixez un objectif par moniteur : le budget restant est calculé à partir des vérifications réellement exécutées. Quand l'historique est insuffisant pour répondre, il le dit au lieu d'afficher un zéro assuré.
slo_target, per monitor
Astreinte
Qui est réveillé, jusqu'à ce que quelqu'un réponde.
Un incident s'annonce sur les canaux de votre équipe dès son ouverture : Slack, Webhook, PagerDuty, Microsoft Teams. Chaque membre de l'équipe est aussi prévenu par e-mail, selon ses propres réglages de notification. Une notification push atteint aussi leurs appareils.
Plannings d'astreinte avec politiques d'escalade, à partir du forfait Starter. Chaque palier alerte la personne d'astreinte ou une personne désignée après son propre délai.
-
La prise en compte met fin aux alertes
La personne qui prend l'incident en charge le prend en compte. Il passe à « Analyse en cours », donc personne plus bas dans l'échelle n'est alerté.
acknowledge → ladder stops -
Un travail planifié ne réveille personne
Une fenêtre de maintenance coupe les alertes par défaut. Tant qu'elle couvre un moniteur, personne n'est alerté et l'incident est tout de même enregistré. Si l'incident est encore ouvert à la fermeture de la fenêtre, la chaîne d'escalade reprend.
maintenance window open → no page -
Un SMS pour une vraie panne
20 SMS par mois pour les pannes confirmées à partir du forfait Starter, davantage sur les forfaits supérieurs. Les SMS sont envoyés aux personnes qui l'ont choisi avec un numéro de téléphone, pour une panne sur un moniteur vérifié depuis plus d'une région.
sms_monthly = 20
- t+0 Canaux de l'équipe envoyé
- t+5m La personne d'astreinte envoyé
- Pris en compte : l'échelle s'arrête ici.
- t+10m La personne suivante non envoyé
Pages de statut
Pendant une panne, votre canal le plus discret est celui qui parle le plus.
Une page que vos clients peuvent atteindre quand plus rien d'autre chez vous ne fonctionne. Elle répond à la question avant qu'elle n'arrive dans votre boîte de réception, et continue de le faire après votre coucher.
- Composants et groupes de composants
- 90 jours de disponibilité par composant
- Historique des incidents avec post-mortems publiés
- Abonnés par e-mail, double opt-in
- Votre couleur de marque et votre logo
- Sur un chemin ou sur son propre sous-domaine
La même page est rendue en image à chaque modification : vous voyez ce que voit un client sans avoir à publier pour le savoir.
Tableau en direct
Un tableau à vous, en direct à chaque vérification.
Épinglez des moniteurs ou des métriques sur un tableau qui n'est qu'à vous : votre disposition ne change rien pour le reste de l'équipe.
- État du moniteur Affichage : une carte.
- Temps de réponse Affichage : une carte, un graphique ou une liste.
- Disponibilité Affichage : une carte.
- Métrique Affichage : une carte, un graphique ou une liste.
Chaque tuile est petite, moyenne ou grande. Les vérifications arrivent par un canal privé en temps réel dès qu'elles ont lieu, donc une tuile se rafraîchit sans rechargement.
check.recorded → tile refreshes
API et agents
Votre surveillance, pilotable par script.
Les clés d'API d'équipe ouvrent la même API que celle sur laquelle l'app tourne, pour vos scripts, votre CI ou un agent de code.
-
Chaque clé ne porte que les droits que vous lui accordez : 19 droits répartis sur 10 ressources. Ou partez d'un préréglage : lecture seule, lecture-écriture, complet.
monitorsmetricsincidentsstatus_pageschannelsoncallmaintenanceboardstatsteam
- Le forfait Free inclut 2 clés.
- Claude Code, ChatGPT, Cursor, Codex ou tout client MCP se connecte au serveur MCP d'Uptizm, avec votre compte Uptizm ou avec une clé d'API d'équipe. Le skill d'agent Uptizm lui apprend à piloter votre surveillance en toute sécurité.
- La documentation est aussi écrite pour être lue par un agent : une spécification OpenAPI, llms.txt, du Markdown pour chaque page.
- Chaque page de statut publique répond aussi sur status.json, plus llms.txt pour un agent.
curl https://api.uptizm.com/v1/me \
  -H "Authorization: Bearer $UPTIZM_API_KEY" \
  -H "Accept: application/json"
Serveur MCP, pour tout client MCP
https://mcp.uptizm.comSkill pour agents
npx skills add uptizm/skillsLes limites de l'IA
Elle lit les mesures, et n'invente rien.
Une IA qui devine une cause est pire que pas d'IA du tout, car à trois heures du matin vous agissez d'après elle. Les limites sont donc tracées d'abord : elle ne cite que les vérifications, régions et métriques qu'elle voit, expose les preuves pour et contre, et dit quand elle ne sait pas.
Vous fixez ce qu'elle a le droit de faire
- Désactivé
- Les seuils et les personnes ouvrent les incidents. L'IA reste à l'écart, mais la détection d'anomalies signale tout de même les mesures inhabituelles dans votre boîte de réception sur les forfaits payants.
- Suggérer
- La détection d'anomalies est statistique et fonctionne à partir du forfait Starter. L'IA qualifie chaque constat et rédige une analyse sur les incidents. Vous décidez.
- Automatique
- Avec Pro, elle ouvre elle-même les incidents d'anomalie, les tient à jour et les résout quand le signal revient à la normale.
Ce qu'elle ne peut pas voir: vos déploiements, vos commits, votre CI; vos logs, vos traces, votre APM; votre CDN, ou la page de statut de quelqu'un d'autre
Uptizm surveille vos points de terminaison de l'extérieur, et c'est tout ce qu'il sait. Il peut donc vous dire que la file a franchi sa limite trois vérifications avant le premier 503. Il ne peut pas vous dire qu'un déploiement en est la cause, et ne fera pas semblant.
Ses suggestions sont des conseils. Aucun bouton ne lui permet de toucher à votre infrastructure, car elle n'a aucun accès.
Et l'IA est incluse dans le forfait, sans facturation par incident. Une IA payée à l'usage envoie sa plus grosse facture le pire jour, et une fonctionnalité que vous hésitez à laisser tourner n'en est pas une.
Obtenir l'app
Le même compte sur chaque écran.
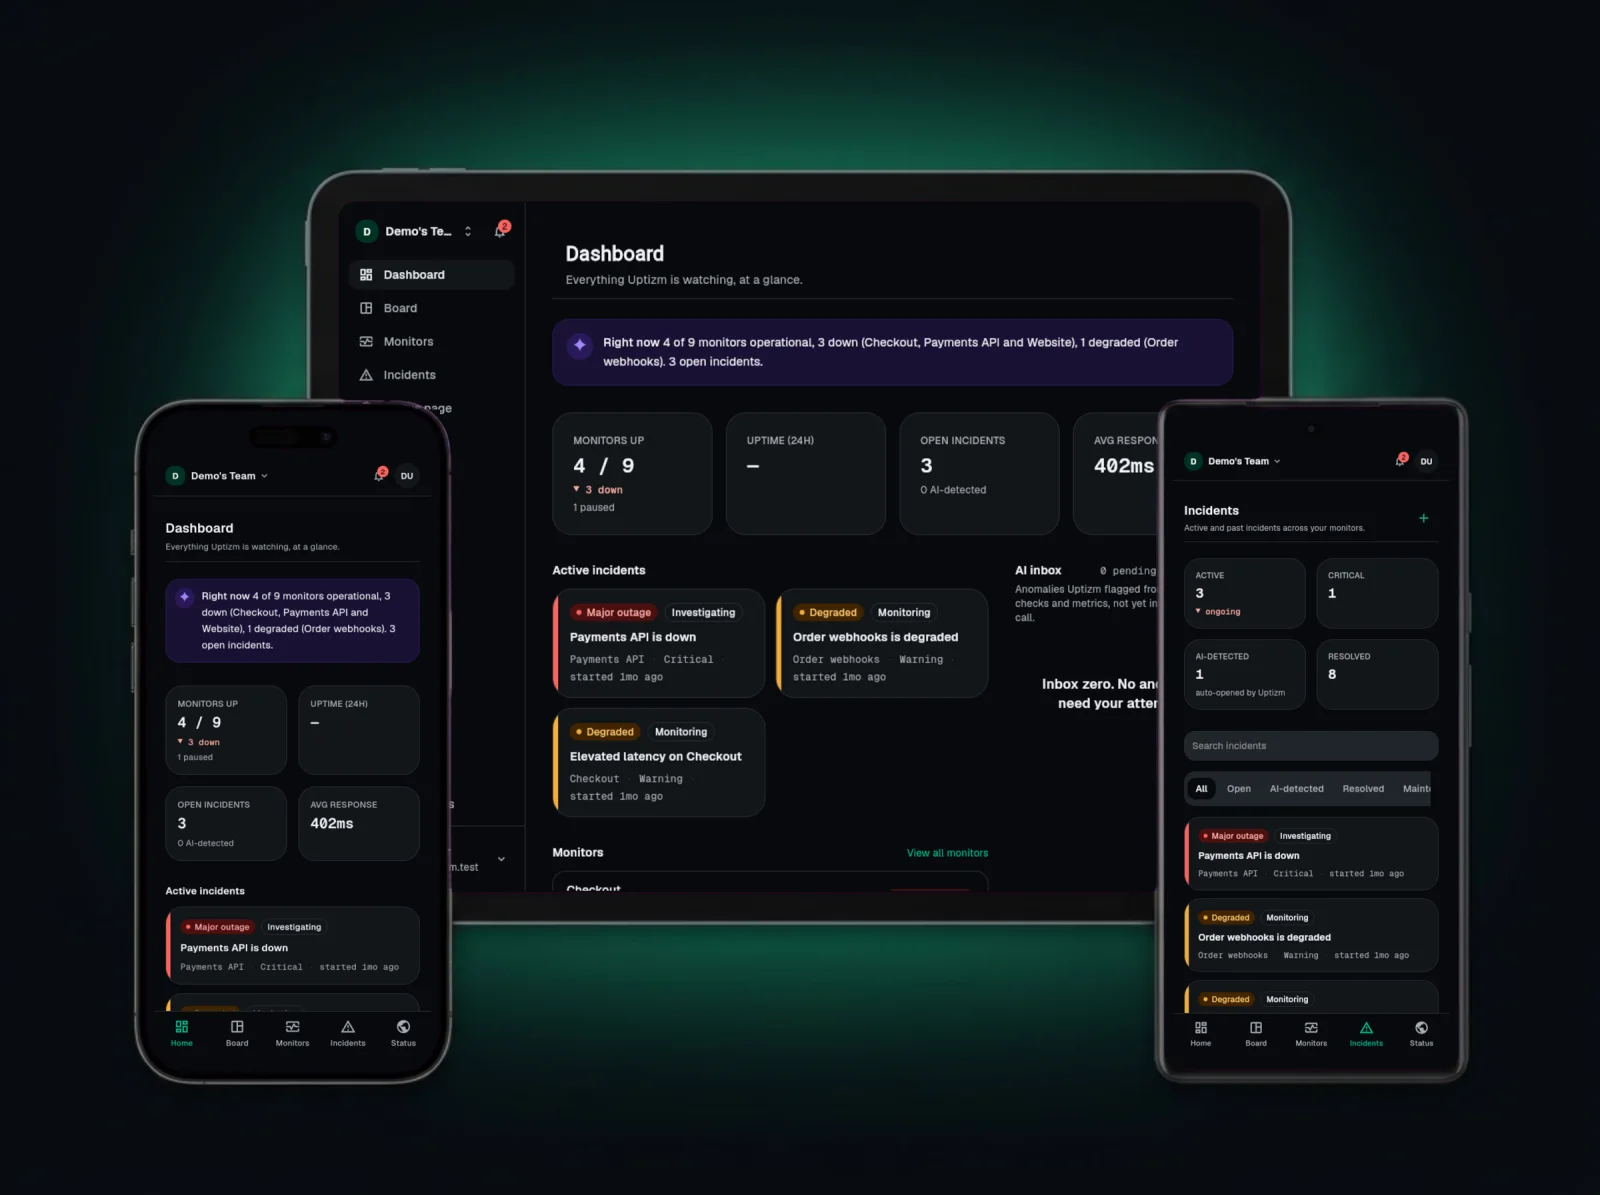
Une seule app pour Web, iOS, Android, construite à partir du même code source. Connectez-vous avec le même compte sur n'importe lequel : la même équipe, les mêmes moniteurs, les mêmes incidents.
Les incidents arrivent sur votre téléphone sous forme de notification push, selon vos propres réglages de notification.